Doanh nghiệp càng phát triển, dữ liệu càng nằm rải rác ở nhiều hệ thống như CRM, ERP, phần mềm kế toán hay Excel. Khi cùng một thông tin xuất hiện ở nhiều nơi nhưng không thống nhất, việc đối chiếu và sử dụng dữ liệu trở nên khó khăn.
Quản lý dữ liệu tập trung giúp doanh nghiệp kết nối các nguồn cần thiết, thống nhất cách quản lý và khai thác dữ liệu cho báo cáo, vận hành, phân tích hoặc AI mà không nhất thiết phải đưa toàn bộ dữ liệu về một cơ sở dữ liệu duy nhất.
Tóm tắt nhanh
Doanh nghiệp có nhiều cơ sở dữ liệu không nhất thiết phải thay toàn bộ hệ thống. Cách tiếp cận phù hợp là: kiểm kê nguồn → xác định dữ liệu chuẩn → chuẩn hóa → kết nối → tạo lớp dữ liệu dùng chung → quản trị quyền/chất lượng → mở kênh khai thác cho báo cáo, vận hành, BI và AI.
Khi nào “nhiều cơ sở dữ liệu” trở thành vấn đề?
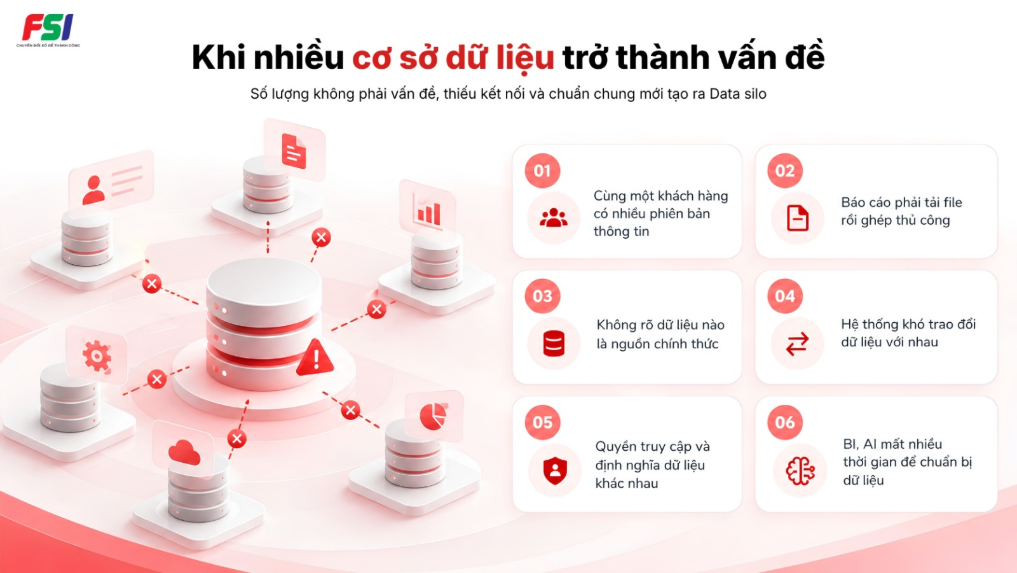
Doanh nghiệp dùng nhiều hệ thống là bình thường. Vấn đề xuất hiện khi dữ liệu giữa các hệ thống không kết nối và không thống nhất.
Một số dấu hiệu dễ nhận biết:
- Cùng một khách hàng nhưng thông tin ở CRM, ERP và Excel khác nhau.
- Làm báo cáo phải lấy dữ liệu từ nhiều nơi rồi ghép thủ công.
- Các phòng ban báo cáo cùng một chỉ số nhưng số liệu không giống nhau.
- Không rõ đâu là nguồn dữ liệu chính xác để sử dụng.
- BI hoặc AI mất nhiều thời gian để làm sạch và chuẩn bị dữ liệu.
Khi đó, doanh nghiệp cần quản lý dữ liệu tập trung để thống nhất nguồn dữ liệu, giảm đối chiếu thủ công và khai thác thông tin hiệu quả hơn.
Quản lý tập trung và khai thác tập trung nên được hiểu thế nào?
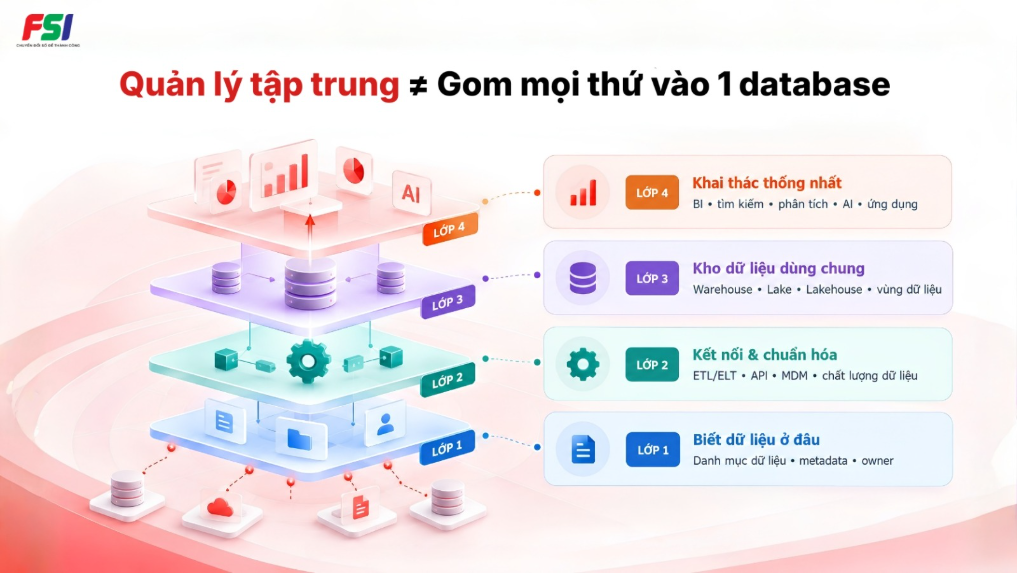
Cách dễ hiểu nhất là tách hai mục tiêu: quản lý tập trung và khai thác tập trung.
Quản lý tập trung: doanh nghiệp phải biết dữ liệu nào đang có và dữ liệu nào đáng tin
Quản lý tập trung không bắt buộc dữ liệu phải nằm cùng một máy chủ. Doanh nghiệp cần có danh mục nguồn dữ liệu, người chịu trách nhiệm, quy tắc đặt tên, tiêu chuẩn chất lượng và quyền truy cập thống nhất.
Ví dụ, thông tin khách hàng có thể vẫn tồn tại trong CRM và ERP. Nhưng doanh nghiệp phải xác định hệ thống nào là nguồn chuẩn cho tên pháp lý, mã khách hàng, địa chỉ hoặc trạng thái giao dịch.
Khai thác tập trung: người dùng không phải tự ghép dữ liệu từ nhiều hệ thống
Sau khi các nguồn được kết nối và chuẩn hóa, người dùng cần một lớp truy cập chung. Đó có thể là dashboard, kho báo cáo, công cụ tìm kiếm, API hoặc nền tảng dữ liệu phục vụ phân tích.
Mục tiêu là để lãnh đạo, nghiệp vụ và đội dữ liệu cùng sử dụng một cách hiểu nhất quán, thay vì mỗi nhóm tự tạo bộ số liệu riêng.
Vì vậy, “tập trung” không đồng nghĩa “một database duy nhất”
Một số dữ liệu có thể được chuyển về Data Warehouse hoặc Data Lake. Một số dữ liệu vẫn nên nằm tại hệ thống nguồn vì lý do vận hành, bảo mật hoặc kỹ thuật.
Doanh nghiệp chỉ cần tập trung những lớp cần thiết để quản trị và khai thác. Cách này giúp tránh dự án thay thế hệ thống quá lớn nhưng vẫn giải quyết được bài toán dữ liệu phân tán.
7 bước quản lý nhiều cơ sở dữ liệu theo một cách thống nhất
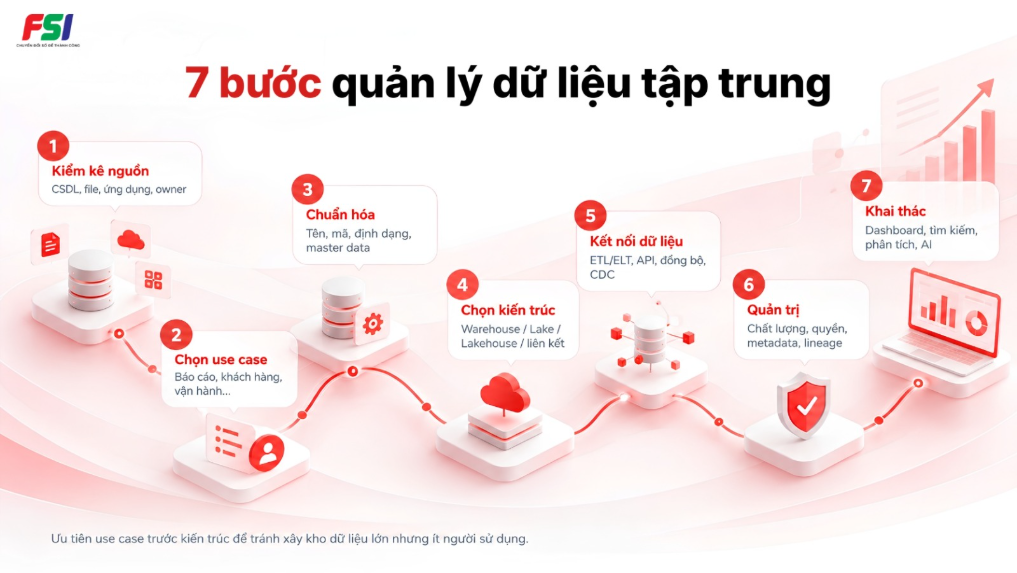
Khi dữ liệu nằm rải rác ở nhiều hệ thống, doanh nghiệp không nên vội gom tất cả về một nơi. Cách thực tế hơn là xử lý từng bước, từ việc biết dữ liệu đang ở đâu đến khi người dùng có thể khai thác thuận tiện.
Bước 1: Biết dữ liệu đang nằm ở đâu
Trước tiên, doanh nghiệp cần liệt kê các nguồn dữ liệu đang sử dụng như CRM, ERP, phần mềm kế toán, Excel hoặc hệ thống nội bộ.
Với mỗi nguồn, chỉ cần làm rõ: dữ liệu gì đang được lưu, phòng ban nào sử dụng và ai chịu trách nhiệm.
Bước 2: Xác định dữ liệu nào quan trọng nhất
Không cần xử lý tất cả cùng lúc. Doanh nghiệp nên ưu tiên những dữ liệu được nhiều bộ phận sử dụng như khách hàng, sản phẩm, đơn hàng, tài chính hoặc tài sản.
Đồng thời cần xác định đâu là nguồn chính thức. Ví dụ, thông tin khách hàng nên lấy từ CRM hay ERP khi hai hệ thống đang khác nhau.
Bước 3: Làm sạch và chuẩn hóa dữ liệu
Dữ liệu từ nhiều hệ thống thường khác cách đặt tên, định dạng hoặc mã hóa.
Doanh nghiệp cần thống nhất cách ghi nhận và xử lý các bản ghi trùng, sai hoặc thiếu. Nếu không làm bước này, dữ liệu dù được tập trung vẫn khó sử dụng chính xác.
Bước 4: Kết nối các hệ thống cần chia sẻ dữ liệu
Sau khi dữ liệu đã rõ và tương đối sạch, doanh nghiệp mới kết nối các hệ thống với nhau.
Mục tiêu là để dữ liệu có thể tự động trao đổi giữa các hệ thống, thay vì nhân viên phải xuất Excel rồi nhập lại thủ công.
Bước 5: Tạo một nơi dùng chung cho báo cáo và phân tích
Những dữ liệu cần sử dụng chung có thể được đưa vào một kho hoặc nền tảng dữ liệu tập trung.
Nhờ đó, người dùng không phải vào từng phần mềm để lấy số liệu rồi ghép lại. Báo cáo và phân tích có thể sử dụng dữ liệu từ cùng một nguồn đã được chuẩn hóa.
Bước 6: Quy định rõ ai được dùng dữ liệu nào
Dữ liệu tập trung cần đi cùng quy tắc quản lý rõ ràng.
Doanh nghiệp nên xác định ai được xem, ai được sửa và ai chịu trách nhiệm về từng nhóm dữ liệu. Các chỉ số quan trọng như doanh thu, khách hàng hoạt động hay tồn kho cũng cần có cách hiểu thống nhất.
Bước 7: Đưa dữ liệu vào sử dụng và đo hiệu quả
Bước cuối là giúp dữ liệu thực sự phục vụ công việc.
Lãnh đạo có thể xem dashboard, các phòng ban sử dụng báo cáo chung, đội dữ liệu thực hiện phân tích và hệ thống khác có thể lấy dữ liệu qua kết nối.
Hiệu quả có thể đo bằng những chỉ số đơn giản như thời gian làm báo cáo giảm bao nhiêu, số lần đối chiếu thủ công giảm thế nào hoặc thời gian tìm dữ liệu có nhanh hơn không.
Điểm quan trọng nhất là: quản lý dữ liệu tập trung không dừng ở việc gom dữ liệu về một chỗ, mà phải giúp doanh nghiệp tìm nhanh hơn, dùng thống nhất hơn và ra quyết định dễ hơn.
Sau khi tập trung, doanh nghiệp khai thác dữ liệu như thế nào?
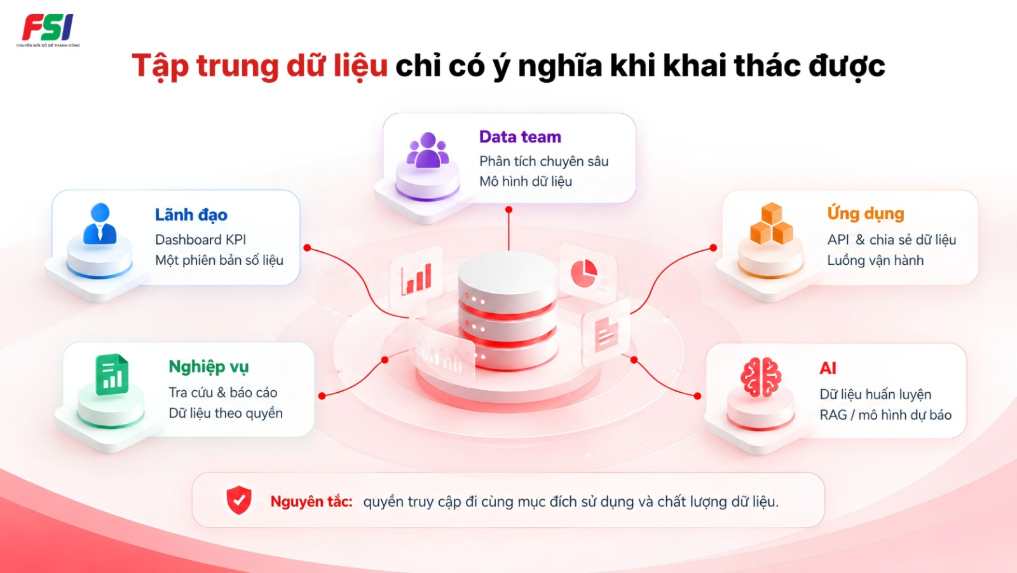
Quản lý dữ liệu chỉ là một nửa bài toán. Nửa còn lại là giúp dữ liệu đi vào hoạt động hằng ngày.
Lãnh đạo: một bộ KPI thống nhất
Dashboard có thể lấy dữ liệu từ nhiều nguồn nhưng hiển thị theo một định nghĩa chung. Lãnh đạo không phải chờ từng phòng ban gửi file và giải thích chênh lệch số liệu.
Phòng nghiệp vụ: tìm kiếm và báo cáo mà không phụ thuộc hoàn toàn vào CNTT
Người dùng cần biết dữ liệu nào đang có và tra cứu theo quyền được cấp. Kho báo cáo, data catalog hoặc tìm kiếm tập trung giúp giảm thời gian hỏi – chờ – tổng hợp.
Ứng dụng: tái sử dụng dữ liệu qua API
Dữ liệu khách hàng, sản phẩm hoặc tài sản có thể được cung cấp cho các ứng dụng khác qua cơ chế chia sẻ thống nhất. Điều này giảm việc mỗi hệ thống tự tạo thêm một bản dữ liệu riêng.
BI và AI: dùng dữ liệu đã có ngữ cảnh và chất lượng
BI và AI cần dữ liệu đủ đúng, có lịch sử và hiểu được nguồn gốc. Khi nền dữ liệu đã được chuẩn hóa và quản trị, thời gian chuẩn bị cho phân tích hoặc AI có thể giảm đáng kể.
Đây là lý do mục tiêu của quản lý dữ liệu tập trung phải là khai thác, không phải chỉ lưu trữ.
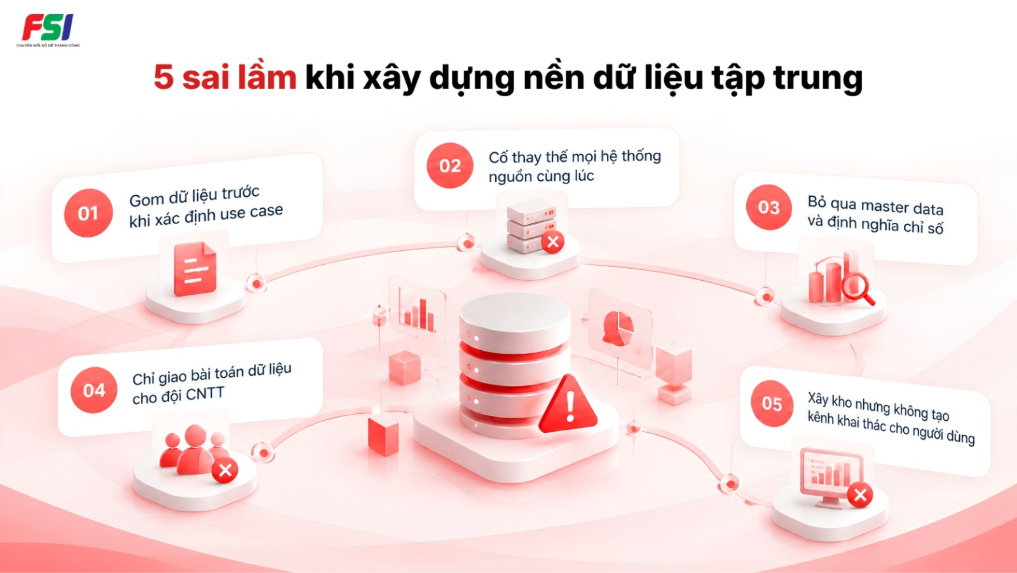
Những sai lầm khiến dự án tập trung dữ liệu không tạo ra giá trị
Gom mọi dữ liệu trước khi biết sẽ dùng để làm gì
Một kho dữ liệu rất lớn có thể vẫn ít giá trị nếu không có use case. Hãy bắt đầu từ báo cáo, quy trình hoặc quyết định cụ thể.
Cố thay thế toàn bộ hệ thống nguồn
CRM, ERP hoặc phần mềm chuyên ngành vẫn có thể tiếp tục vận hành. Kết nối và quản trị trước thường thực tế hơn thay thế đồng loạt.
Chỉ làm phần kỹ thuật, bỏ qua cách hiểu dữ liệu
Nếu mỗi phòng ban vẫn định nghĩa chỉ số khác nhau, hệ thống tập trung không giải quyết được xung đột số liệu.
Không xác định data owner
Dữ liệu cần người chịu trách nhiệm về chất lượng và cách sử dụng. Không có owner, lỗi dữ liệu dễ tồn tại mà không ai xử lý.
Xây kho xong mới nghĩ đến người dùng
Dashboard, tìm kiếm, API và self-service nên được thiết kế cùng dự án. Người dùng phải thấy giá trị sớm để nền dữ liệu thực sự được sử dụng.
FSI hỗ trợ doanh nghiệp quản lý và khai thác dữ liệu tập trung như thế nào?
Với định hướng chuyển đổi số lấy dữ liệu làm trung tâm, FSI cung cấp các giải pháp hỗ trợ doanh nghiệp từ kết nối, lưu trữ và xử lý dữ liệu đến khai phá và đưa dữ liệu vào vận hành.
Khi dữ liệu nằm ở nhiều hệ thống, FSI hỗ trợ kết nối và tổng hợp dữ liệu từ nhiều nguồn, đồng thời xây dựng môi trường lưu trữ, xử lý và chia sẻ dữ liệu tập trung. Nhờ đó, doanh nghiệp có thể giảm tình trạng dữ liệu rời rạc và thuận lợi hơn khi sử dụng dữ liệu giữa các hệ thống.
Ở bước khai thác, giải pháp tìm kiếm dữ liệu tập trung của FSI cho phép tìm kiếm trên nhiều tệp và cơ sở dữ liệu, kết hợp bộ lọc và báo cáo thống kê. Người dùng có thể tiếp cận thông tin từ nhiều nguồn mà không phải tìm kiếm riêng trên từng hệ thống.
Từ nền dữ liệu được kết nối và quản lý thống nhất, doanh nghiệp có thể tiếp tục sử dụng dữ liệu cho báo cáo, phân tích và các hoạt động vận hành, từng bước tạo nền tảng cho chuyển đổi số dựa trên dữ liệu.
Tìm hiểu thêm: Chuẩn hóa dữ liệu tại FSI | Giải pháp tìm kiếm dữ liệu tập trung
NHIỀU CƠ SỞ DỮ LIỆU KHÔNG NHẤT THIẾT PHẢI GOM VỀ MỘT CHỖ
Điều cần tập trung là cách kết nối, chuẩn hóa, quản trị và khai thác. Bắt đầu từ một use case cụ thể sẽ giúp lộ trình rõ và dễ đo hiệu quả hơn.
Kết luận
Khi doanh nghiệp có quá nhiều cơ sở dữ liệu, cách xử lý hiệu quả không phải là thay thế tất cả hệ thống hoặc dồn mọi dữ liệu vào một database duy nhất.
Điều cần làm là xác định dữ liệu nào quan trọng, đâu là nguồn chuẩn, chuẩn hóa dữ liệu, kết nối các hệ thống cần thiết và tạo một lớp quản lý – khai thác thống nhất.
Khi người dùng có thể lấy đúng dữ liệu mà không phải ghép file thủ công, các báo cáo dùng cùng định nghĩa và dữ liệu sẵn sàng cho BI hoặc AI, lúc đó doanh nghiệp mới thực sự chuyển từ “có nhiều dữ liệu” sang “khai thác được dữ liệu”.
Câu hỏi thường gặp
1. Có nhiều cơ sở dữ liệu có phải là vấn đề không?
Không. Nhiều cơ sở dữ liệu là bình thường nếu mỗi hệ thống có vai trò rõ và dữ liệu có thể kết nối. Vấn đề xuất hiện khi dữ liệu bị cô lập, trùng lặp hoặc khó xác định nguồn đúng.
2. Có cần gom mọi database vào một nơi không?
Không. Doanh nghiệp có thể giữ hệ thống nguồn và chỉ đồng bộ dữ liệu cần thiết. Tập trung nên ưu tiên ở lớp quản trị, chuẩn hóa và khai thác.
3. Nên bắt đầu quản lý dữ liệu tập trung từ đâu?
Nên bắt đầu từ một use case cụ thể, sau đó kiểm kê các nguồn liên quan, xác định nguồn chuẩn và chuẩn hóa dữ liệu trước khi kết nối.
4. Quản lý dữ liệu tập trung có hỗ trợ AI không?
Có thể tạo nền tảng tốt hơn vì AI cần dữ liệu đủ chất lượng, có ngữ cảnh và quyền truy cập rõ. Tuy nhiên, từng use case AI vẫn cần được đánh giá riêng.
5. Bao lâu thì nên mở rộng sang nhiều domain dữ liệu?
Nên mở rộng khi use case đầu tiên đã vận hành ổn định, dữ liệu có owner, quy tắc chất lượng rõ và kết quả sử dụng được đo lường.